METODOS
ESTADÍSTICOS (CO-OCURRENCIAS)
Estadísticas de Orden
Inferior
Como estadísticas de orden inferior se consideran aquella
que sólo analizan un pixel y su vecino más inmediato. Dentro de estas
estadísticas de orden inferior se encuentran las de primero y segundo orden.
ESTADISTICAS DE PRIMER ORDEN
Estas
estadísticas, se basan en un vector denominado Vector de densidad de probabilidad Pf(z)
que se obtiene a partir de la imagen original y que se define como:
-
Indica cuánto se repite cada nivel
de gris.
-
Si la imagen f contiene k niveles
de grises Pf(z) será un vector con k componentes,
una por cada nivel de gris.
Ejemplo (Estadísticas de primer orden)
|
1 |
15 |
0 |
2 |
|
0 |
0 |
5 |
6 |
|
5 |
3 |
0 |
7 |
|
0 |
7 |
8 |
9 |
En este caso el Vector de densidad de probabilidad
sería:
|
0 |
1 |
2 |
3 |
4 |
5 |
6 |
7 |
8 |
9 |
10 |
11 |
12 |
13 |
14 |
15 |
|
5 |
1 |
1 |
1 |
0 |
2 |
1 |
2 |
1 |
1 |
0 |
0 |
0 |
0 |
0 |
1 |
16 NIVELES DE GRIS
El
vector anterior proporciona información sobre la comunidad de niveles de gris
de la imagen. A partir de dicho vector se calculan las siguientes estadísticas:
·
Media
·
Varianza
·
Desviación Típica
ESTADISTICAS DE SEGUNDO ORDEN
Las estadísticas de segundo orden se basan en:
-
Un desplazamiento relativo
-
Una matriz cuadrada de orden k
llamada Matriz de distribución espacial Md
tal que
siendo d=(Dx,Dy)
tenemos:
- (i, j) Î
Md es el
‘número de veces que un punto de nivel de gris zi ocurre en la posición
relativa d
de un punto de nivel de gris zj.
Ejemplo
(Estadísticas de segundo orden)
Si consideramos sólo 3 niveles de gris tenemos y un desplazamiento d
= (1,0)
|
1 |
1 |
0 |
2 |
|
0 |
0 |
2 |
1 |
|
2 |
2 |
0 |
1 |
|
0 |
1 |
1 |
2 |
En este caso su matria de distribución espaciál será:
|
1 |
2 |
2 |
|
1 |
2 |
1 |
|
1 |
1 |
1 |
A partir de la matriz anterior se obtienen las
estadísticas de segundo orden que son:
·
Contraste
·
Momento de diferencia inverso
·
Momento Angular secundario
(Uniformidad)
·
Entropía (Desorden)
Problemas de las estadísticas de orden inferior
El primer
problema que se presenta está relacionado con las estadísticas de primer orden.
Aquí, si tenemos dos imágenes con el mismo número de pixel blanco que negro,
vamos a obtener una estadística similar para ambas imágenes.
Ejemplo:
IMAGEN 1 IMAGEN
2
|
15 |
15 |
15 |
15 |
|
0 |
0 |
0 |
0 |
|
15 |
15 |
15 |
15 |
0 |
0 |
0 |
0 |
|
|
0 |
0 |
0 |
0 |
15 |
15 |
15 |
15 |
|
|
0 |
0 |
0 |
0 |
15 |
15 |
15 |
15 |
Por
otra parte las estadísticas de segundo orden tienen un problema similar y
es que no son capaces de diferenciar
ciertos tipos de texturas.
Por ejemplo, si consideramos dos imágenes que
son dos tableros de ajedrez como los
siguientes:
TABLERO 1
|
0 |
15 |
0 |
15 |
0 |
|
15 |
0 |
15 |
0 |
15 |
|
0 |
15 |
0 |
15 |
0 |
|
15 |
0 |
15 |
0 |
15 |
|
0 |
15 |
0 |
15 |
0 |
TABLERO 2
|
15 |
0 |
15 |
0 |
15 |
|
0 |
15 |
0 |
15 |
0 |
|
15 |
0 |
15 |
0 |
15 |
|
0 |
15 |
0 |
15 |
0 |
|
15 |
0 |
15 |
0 |
15 |
En este
caso si calculamos las estadísticas de segundo orden para cada uno de los
tableros, obtenemos unas estadísticas idénticas para ambas imágenes.
Contraste
|
225 |
|
Momento
de diferencia inverso |
0.0044 |
|
Momento
Angular secundario |
0.5 |
|
Entropía |
0.301 |
Este
problema se debe a que las distintas matrices de distribución espacial Md para las
distintas orientaciones (0º,45º,90º,135º,180º,225º,270º,315º) son iguales en
ambas imágenes.
Debido
a los problemas anteriores, se puede decir que las estadísticas de orden
inferior no contienen información suficiente para caracterizar ciertos tipos de
texturas irregulares.
Estadísticas de orden superior
·
Matriz
de dependencia del nivel de gris entre sus vecinos (NGLDM)
Este
método se caracteriza por:
-
En este método se consideran todo
los vecinos de un pixel al mismo tiempo
(El número de vecinos depende del tipo de vecindad que se elija)
-
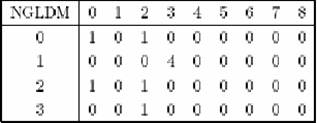
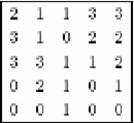
Dada
una imagen, se define la matriz (NGLDM)
q(k,s) como el número de pixeles con nivel de gris k,
que tienen s vecinos con un nivel de
gris similar, y que se encuentran a una distancia d.
Ejemplo:
·
Matriz
de secuencias de niveles de gris (GLRLM)
Este
método se caracteriza por:
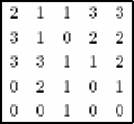
-
Dada
una imagen, se define la matriz run-length
p(i,j)
como el número de
secuencias con pixeles
de nivel de gris i
y longitud j.
-
Este método se puede aplicar
siguiendo cuatro direcciones (0º,
45º, 90º y 135º).
Ejemplo:
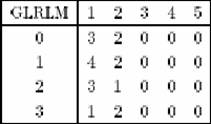
A
partir de la matriz original (GLRLM) se obtiene otras matrices que pueden ser
interesantes ante la búsqueda de ciertas características de la imagen.
1.- Gray Level Run-Length Pixel Number Matrix:
Pp (i,
j) = P(i, j) * j
Cada elemento de
la matriz nos indica el número de pixeles con nivel de gris i, en secuencias de longitud j.
2.- Gray-Level Run-Number Vector:
N
Pg (i) = å
P(i, j)
j=1
Cada elemento del
vector nos muestra el número de secuencias con nivel de gris i.
3.- Run-Length Run-Number Vector
M
Pr (j)
= å P(i, j)
i=1
Cada elemento del
vector nos muestra el número de secuencias con longitud j.
4.- Gray-Level Run-Length-One Vector
Po
(i) = P (i, 1)
Cada elemento del
vector nos muestra las secuencias de longitud 1, para el nivel de gris i.
Mediante diversas simulaciones se ha demostrado que el
vector que representa las secuencias de longitud 1, contiene la mayor parte de la información de la textura
Partiendo
de la matriz original de secuencias P(i,j) se obtienen inicialmente las siguientes Medidas Estadísticas:
M : número de niveles de gris.
N: longitud máxima de las series.
1)
Peso de las Secuencias Cortas (SRE)
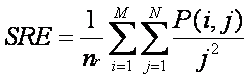
nr:número de secuencias
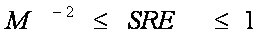
Tomará el
valor 1
cuando todos los tramos sean de longitud 1
2) Peso de las Secuencias Largas
(LRE)
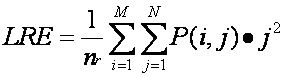
3) Uniformidad del Nivel de Gris
(GLN)
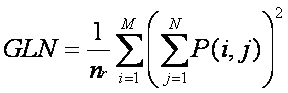
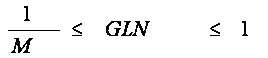
Toma el valor 1
cuando el nivel de gris es totalmente uniforme
4) Uniformidad de la Longitud de las Secuencias (RLN)
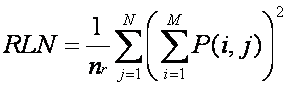
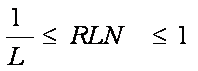
Toma el valor
1 cuando la longitud de las secuencias es totalmente uniforme
5) Porcentaje de las series (RP)
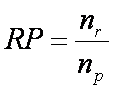
np:número de pixeles de la imagen
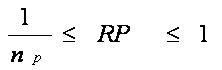
Posteriormente se definen dos nuevas características:
1)
Peso de las Secuencias de Nivel de Gris Bajo (LGRE)
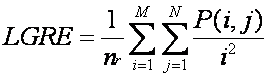
2) Peso de la
Secuencias de Nivel de Gris Alto (HGRE)
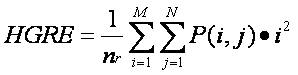
En estudios más recientes Dasarathy and Holder describen
cuatros rasgos combinando los niveles de gris y la longitud de las secuencias
1)
Peso de las Secuencias Cortas con Nivel de Gris Bajo
(SRLGE)
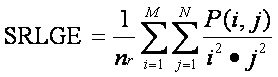
2) Peso de las Secuencias Cortas con Nivel de Gris Alto (SRHGE)
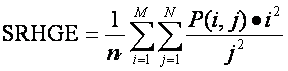
3) Peso de las Secuencias Largas con Nivel de Gris Bajo (LRLGE)
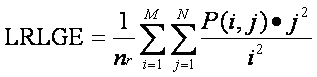
4) Peso de las Secuencias Largas con Nivel de Gris Alto (LRHGE)
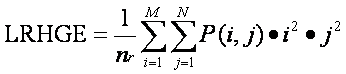
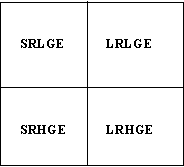
Mediante simulación se ha comprobado que las cuatros
características anteriores son las mejores para diferenciar texturas